云知声发布U2-Flash高密度智能模型,重塑大模型实战能力
2026-09-15 17:38:03 来源:科智网


近日,云知声正式推出新一代高密度智能模型U2-Flash。该产品并非U2系列的精简版本,而是面向生产力场景打造的全新主力智能形态。依托稀疏混合专家架构与系统性后训练技术,U2-Flash实现强能力、快响应、低成本的综合优势,同时完成国产算力适配,为企业行业落地提供新选择。

依托先进架构与自研训练体系,构筑高密度智能能力底座
在能力构建方式上,U2-Flash 有两个鲜明立场:一是让模型深度参与自身训练闭环的演进——从生成训练数据、分析轨迹到巡检修复训练系统——这是递归自我改进(RSI)方向的第一步实践,也是贯穿技术设计的主线;二是让模型在隐藏状态空间中进行深度思考(Latent Reasoning),并将思考能力封装为用户可控的思考强度接口,而非不可观测的黑箱。
在架构上,U2-Flash 采用稀疏混合专家(MoE)设计,总参数约 266B,但单次推理仅激活约 10B 参数(激活比例不到总参数的 4%),把编程、Agent、数学推理、指令遵循等多领域能力统一编码进同一套权重,使用远小于同类模型的激活规模,撬动主力级的任务完成质量——其综合能力已可比肩市面上主力模型。而支撑这套架构能力充分释放的,正是系统性的后训练机制——它让模型从“能做事”进化到“会做事”。
突破AI能力边界,多项测试超越主流模型
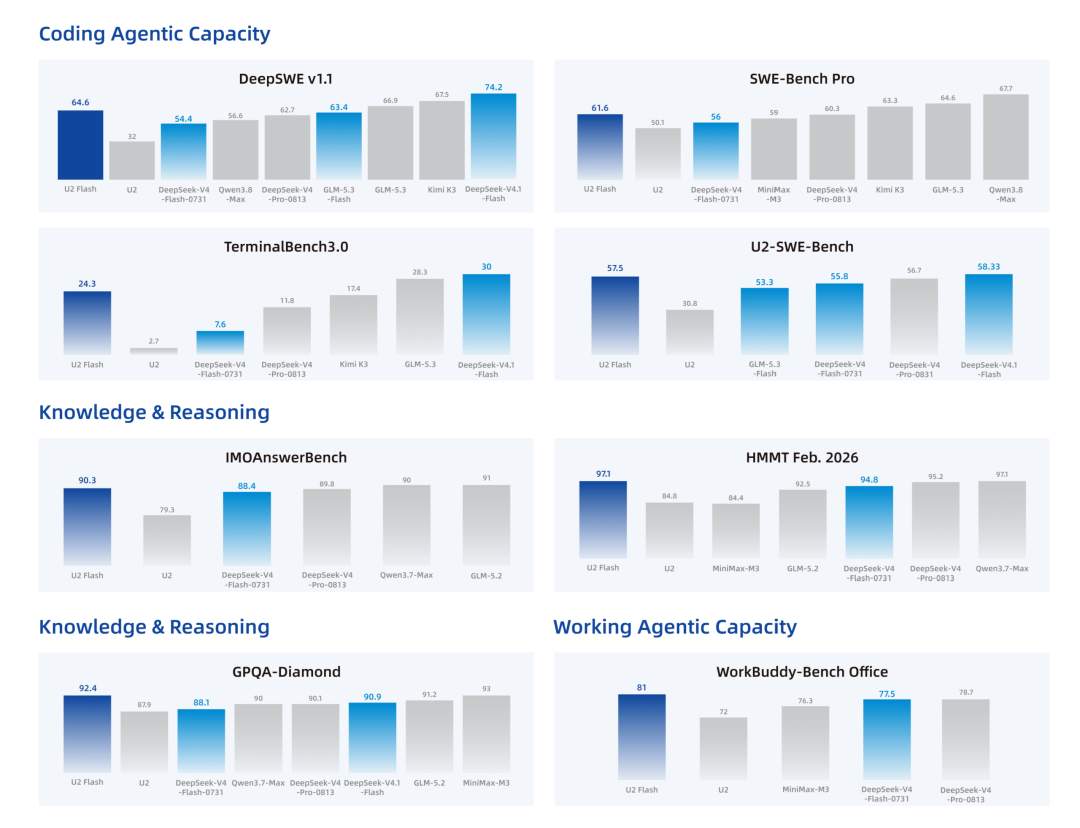
在真实业务场景中,模型能力的竞争已经从“能否回答问题”走向“能否完成复杂任务”。相较上一代 U2 模型,U2-Flash 实现了跨代式的全面跃升,在代码、Agent、高阶推理和办公自动化等核心场景中展现出压倒性的优势,并在多项权威基准测试中刷新纪录:
在代表编程能力的 DeepSWE v1.1 榜单中,U2-Flash 斩获 64.6 分,较上一代实现翻倍式增长,一举超过 GLM5.3-Flash、DeepSeek-V4-Pro-0813 等模型。在 TerminalBench 3.0 测试中飙升至 24.3 分,直接超越 K3 等万亿参数级别模型;在 SWE-Bench Pro 测试中更是交出 61.6 分的高分,较前代大幅跃升 10.5 分。
当前的大模型竞争,正从单纯比拼参数量转向落地价值比拼。企业用户更加关注任务完成质量、响应时延、调用成本与算力适配性。U2-Flash的推出,体现了行业一个重要方向:以稀疏架构、后训练机制挖掘模型能力上限,结合真实场景积累,在国产算力底座上交付可规模化落地的生产力模型。未来,具备场景深耕能力、自主可控迭代能力、多算力兼容能力的模型方案,将进一步推动大模型从概念验证走向深度产业落地。
当前AI大模型行业已告别参数内卷的粗放发展阶段,迈入高效率、低成本、可落地的价值竞争新时期。云知声U2-Flash的问世,精准契合产业智能化转型的核心需求,凭借先进架构、超强实操能力与国产算力适配优势,破解了企业落地大模型的成本、效率与适配难题。这也为行业树立了轻量化高质效的发展标杆,推动AI大模型真正扎根产业场景、实现规模化商用。
【广告】免责声明:本内容为广告,相关素材由广告主提供,本文仅代表作者个人观点,与本网无关。本网发布目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责,广告内容仅供读者参考,请自行核实相关内容。